
ГлавнаяХаб аналитикиState of AI vs. Human Code Generation Report
CodeRabbitState of AI vs. Human Code Generation Report


Компания CodeRabbit проанализировала, как использование ИИ при написании кода влияет на его качество. Авторы изучили 470 реальных запросов на внесение изменений в код (Pull Requests) из открытых проектов на платформе GitHub, из которых 320 были помечены как созданные с участием ИИ, а 150 — как написанные разработчиками без его использования.
Проверка велась по единой методике и охватывала такие аспекты, как логика работы программы, удобство чтения и поддержки кода, безопасность и производительность. Результаты приводились в расчете на 100 запросов.
Ключевые выводы:
- в коде, написанном с помощью ИИ, в среднем выявлялось 10,8 проблемы на один запрос на внесение изменений, тогда как в написанном людьми без ИИ — 6,4. В целом использование ИИ приводило к примерно в 1,7 раза большему числу ошибок;
- в коде, созданном с применением ИИ, серьезных и критических ошибок обнаруживалось заметно больше, чем в написанном людьми. Число критических проблем было выше примерно в 1,4 раза, а серьезных — в 1,7 раза;
- ошибки логики и корректности в коде с участием ИИ возникали на 75% чаще, чем в коде, созданном людьми. Речь идет об ошибках в алгоритмах, неверном порядке действий и некорректных настройках, которые часто приводят к сбоям и инцидентам;
- проблемы читаемости кода в вариантах, написанных с помощью ИИ, появлялись более чем в три раза чаще по сравнению с кодом, созданным без его участия. Это выражалось в неясных названиях, запутанной структуре и несоблюдении принятых в команде правил оформления;
- пробелов в обработке ошибок и нестандартных ситуаций встречалось почти в два раза больше в коде, созданном с подключением ИИ, чем в коде, написанном специалистами. В таких случаях часто отсутствовали проверки на пустые значения, защитные условия и корректная реакция на сбои;
- по числу проблем безопасности код с участием ИИ значительно опережал написанный без его участия. В целом таких ошибок было в 1,6 раза больше, а ошибки, связанные с неправильной работой с паролями, например хранение паролей в открытом виде или небезопасная проверка доступа, появлялись примерно в два раза чаще;
- проблемы производительности встречались редко, но их обнаруживалось значительно больше в коде, написанном с помощью ИИ. В частности, избыточные операции ввода-вывода происходили примерно в восемь раз чаще, чем в коде, созданном людьми;
- ошибки, связанные с одновременной работой разных частей программы и зависимостями между ними, в коде с участием ИИ возникали примерно в два раза чаще. Это включало неправильный порядок выполнения действий и некорректное использование механизмов параллельной работы, что могло приводить к нестабильности системы;
- проблемы форматирования — лишние пробелы, неверные отступы, несогласованная структура — в коде, написанном с помощью ИИ, появлялись в 2,6 раза чаще, чем в коде специалистов;
- несогласованностей в названиях переменных, функций и других элементов в коде с участием ИИ было почти в два раза больше, чем в коде, созданном специалистами. Использование разных терминов для одного и того же или слишком общих названий увеличивало нагрузку на тех, кто проверяет и поддерживает такой код.
 К2Тех
Готовность промышленных компаний к достижению поставленных результатов по ИИ
В 79% промышленных предприятий ожидания руководства от ИИ превышают реальные возможности компании.Подробнее Syssoft
Российский рынок систем резервного копирования увеличился на 18%
Около 70% крупных компаний используют западные системы резервного копирования.Подробнее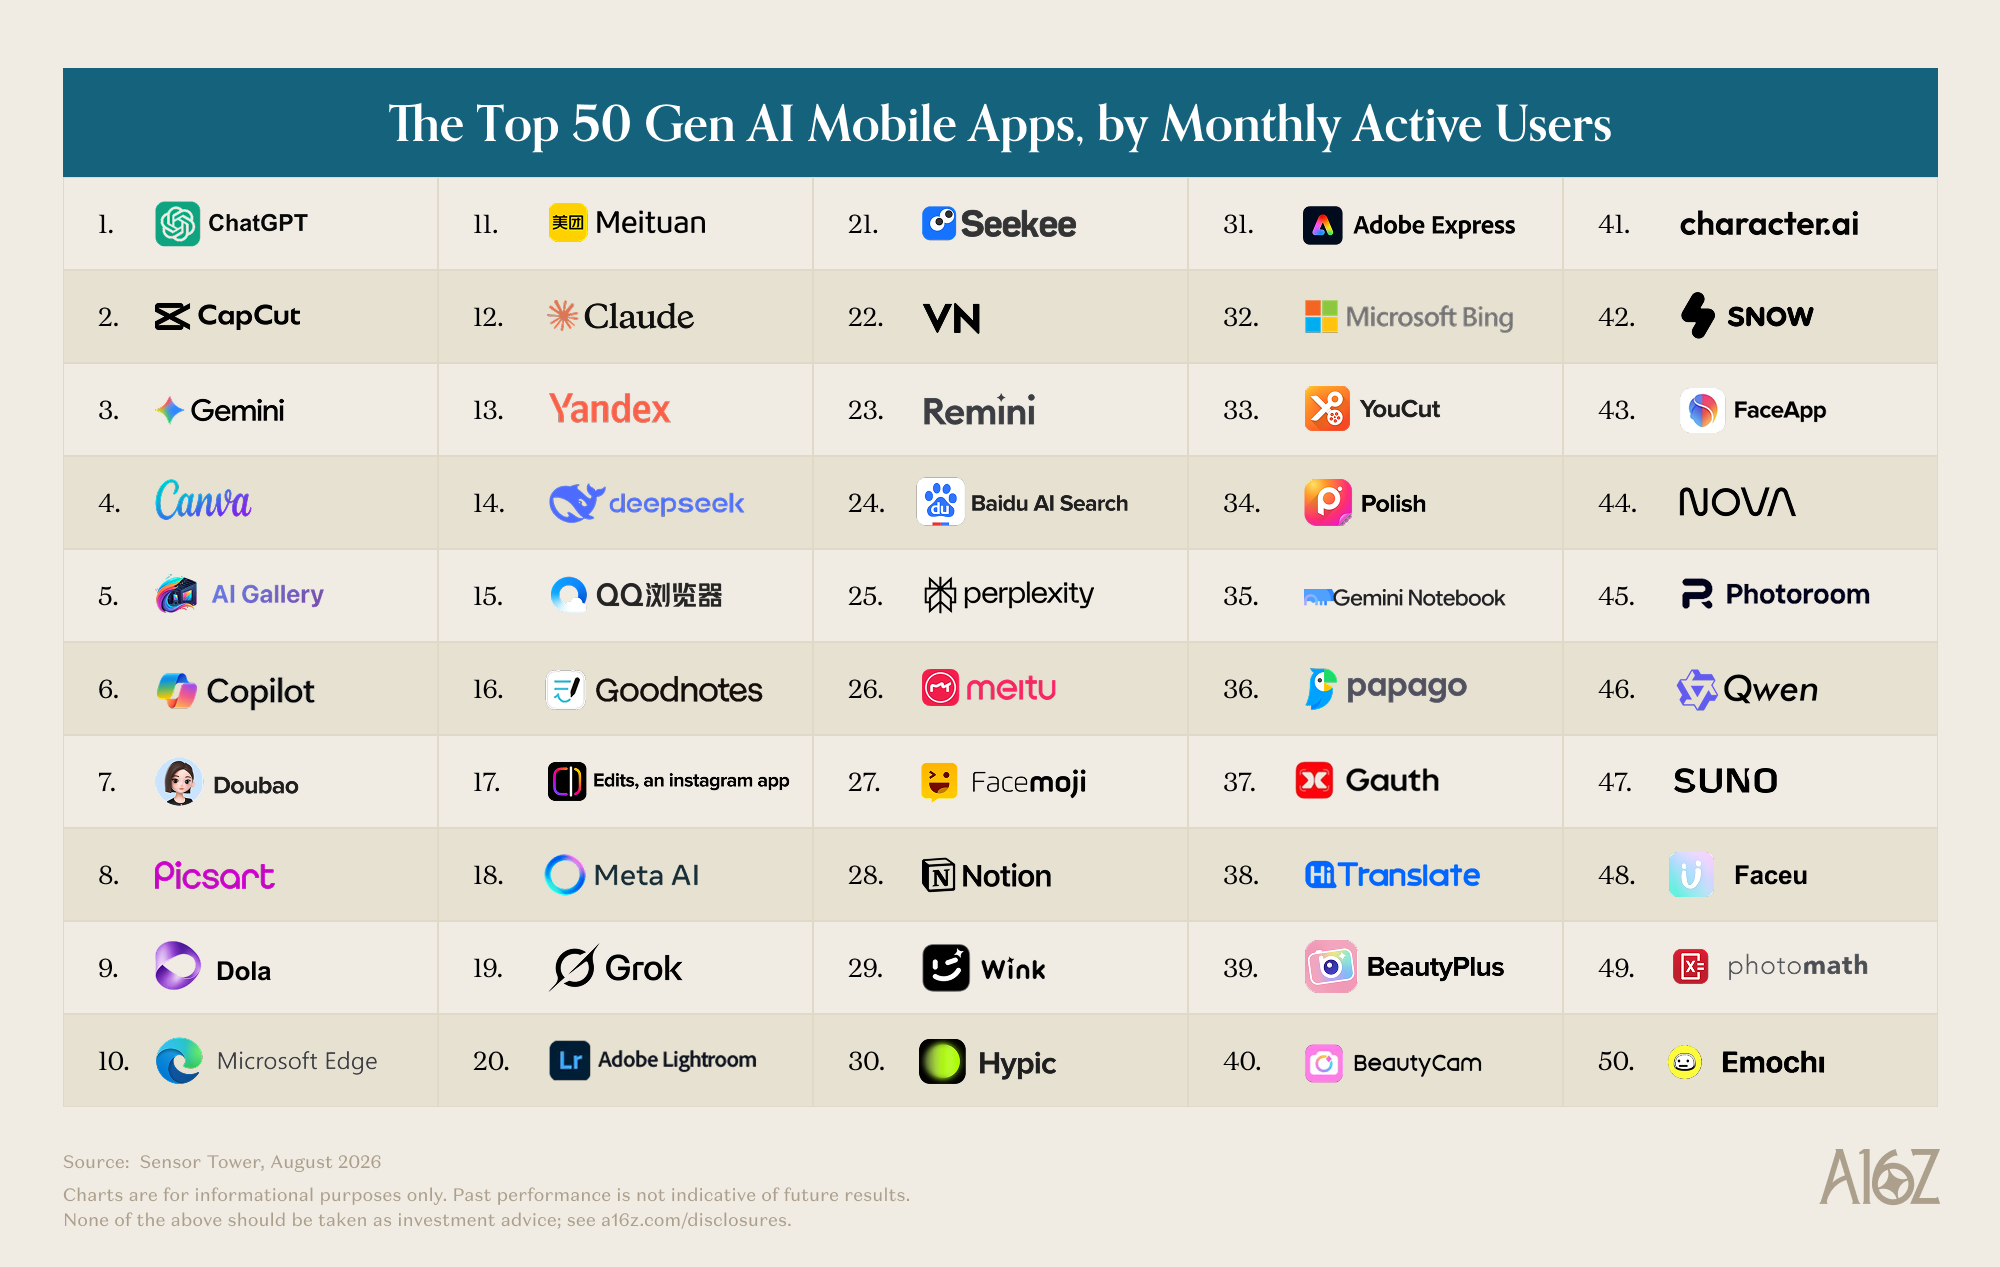 a16z
The Top 100 Gen AI Consumer Apps — 7th Edition
«Яндекс Браузер с Алисой AI» занял 13-е место в мировом рейтинге мобильных приложений на базе ГенИИ.Подробнее Яндекс
Отчет «Яндекс Образования» за 2025–2026 учебный год
На программах «Яндекса» в 46 вузах обучаются 15 тыс. студентов.Подробнее
Нажимая на кнопку, вы соглашаетесь с политикой конфиденциальности
ICT.Moscow — открытая площадка о цифровых технологиях в Москве. Мы создаем наиболее полную картину развития рынка технологий в городе и за его пределами, помогаем бизнесу следить за главными трендами, не упускать возможности и находить новых партнеров.